Gaming Parts Monitor
Une plateforme de comparaison de prix de matériel informatique au Maroc, avec une seconde édition pour l'Algérie. Un recensement quotidien de 20 revendeurs marocains et de plus de 16 000 composants, avec historique des prix, détection de bonnes affaires par rapport à la médiane du marché, un configurateur de compatibilité matérielle et une place de marché d'occasion. FastAPI + Scrapling + PostgreSQL avec interface Next.js 15.
RôleIngénieur Full-Stack & Data
- Crawl Quotidien
- 20 Revendeurs
- Catalogue
- 16 359 Composants
- Annonces
- 37 353
- Édition Algérienne
- 28 Revendeurs
- Python
- FastAPI
- Next.js
- PostgreSQL
- Scrapling
- Docker
- TypeScript
- Tailwind CSS
- TanStack Query
- Zustand
- Clerk
- Caddy
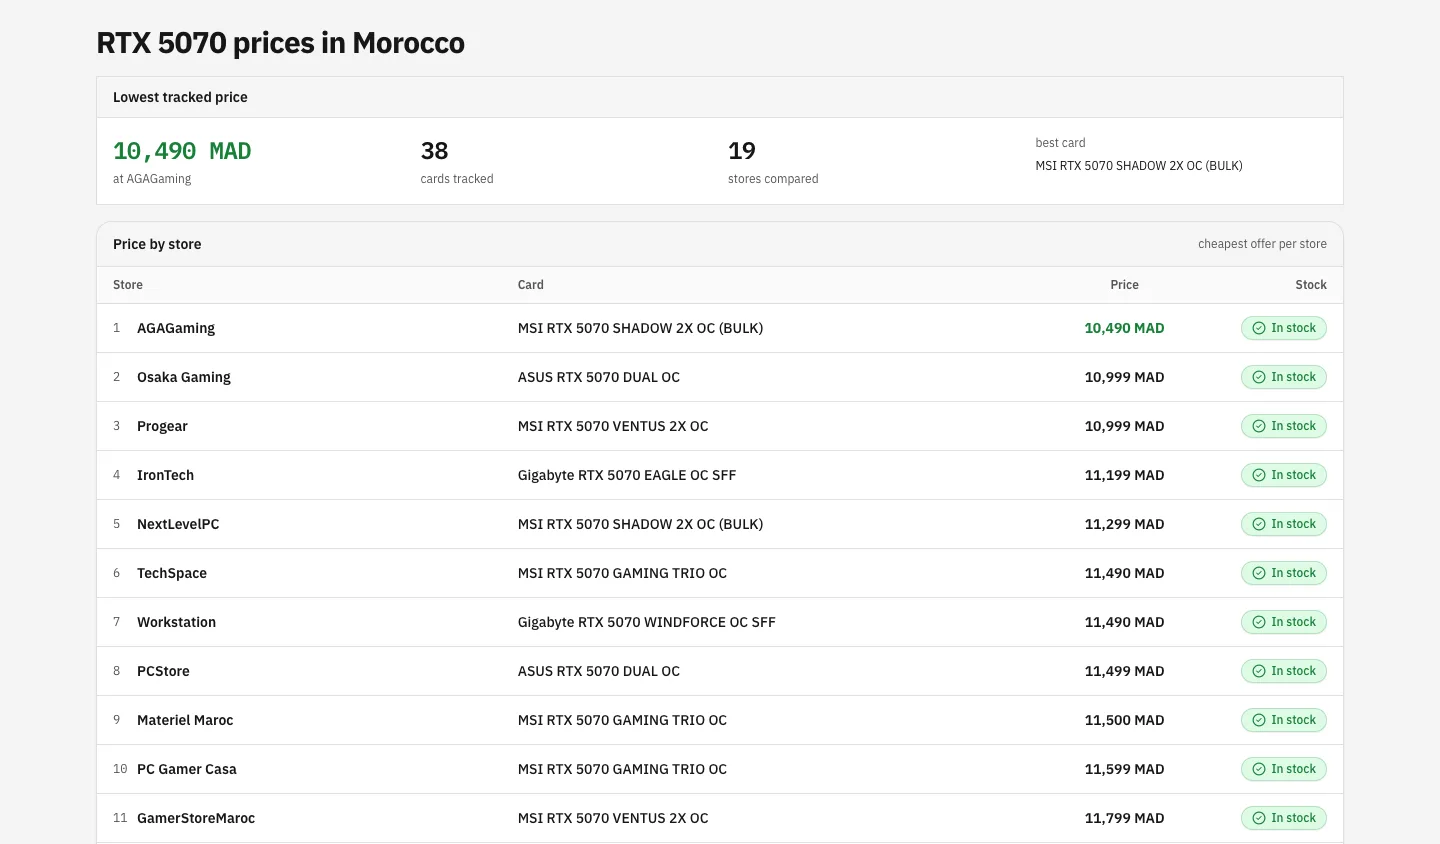
Acheter un composant de PC au Maroc, c’est ouvrir une dizaine d’onglets. Chaque revendeur marocain nomme le même produit à sa façon, fixe son prix de son côté et se réapprovisionne à son rythme. Les comparateurs internationaux n’explorent pas les boutiques locales, et les forums répètent le prix qu’un internaute a vu la semaine dernière.
Gaming Parts Monitor (gamingparts.ma) est ce que j’ai construit pour combler ce manque.
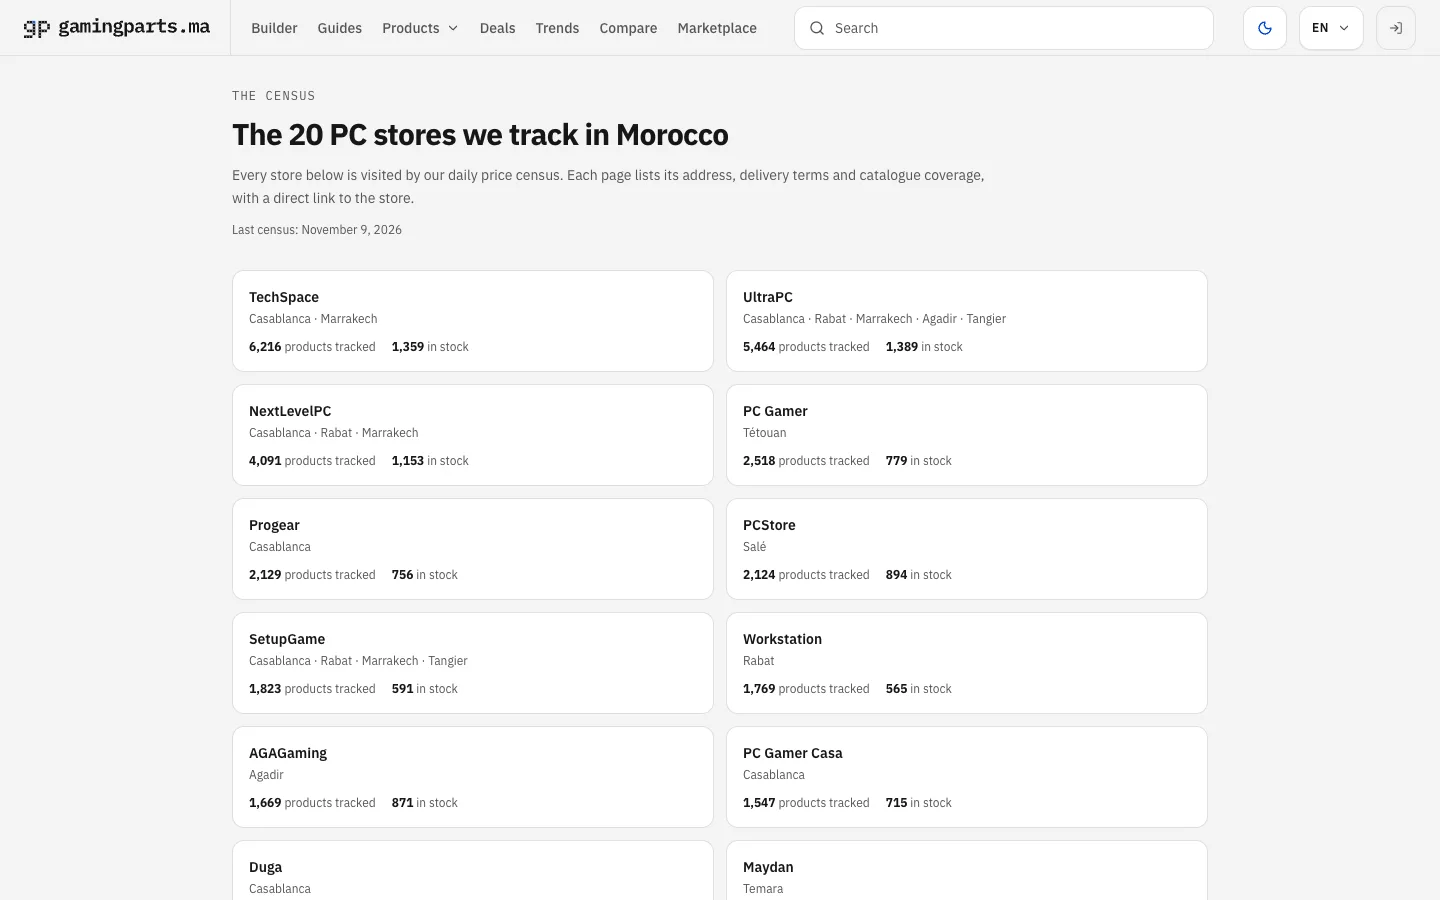
Chaque matin à 04h00, heure de Casablanca, il explore 20 revendeurs marocains, fusionne
leurs catalogues en un graphe de produits canonique et enregistre un prix par boutique et
par jour. Le site suit aujourd’hui 16 359 composants à travers 37 353 annonces. Le
même code fait aussi tourner une édition algérienne, gamingpartsdz.com, qui couvre
28 revendeurs algériens et 10 533 composants, en dinars. Les chiffres proviennent des
sites en production au 9 novembre 2026.
Le produit aujourd’hui
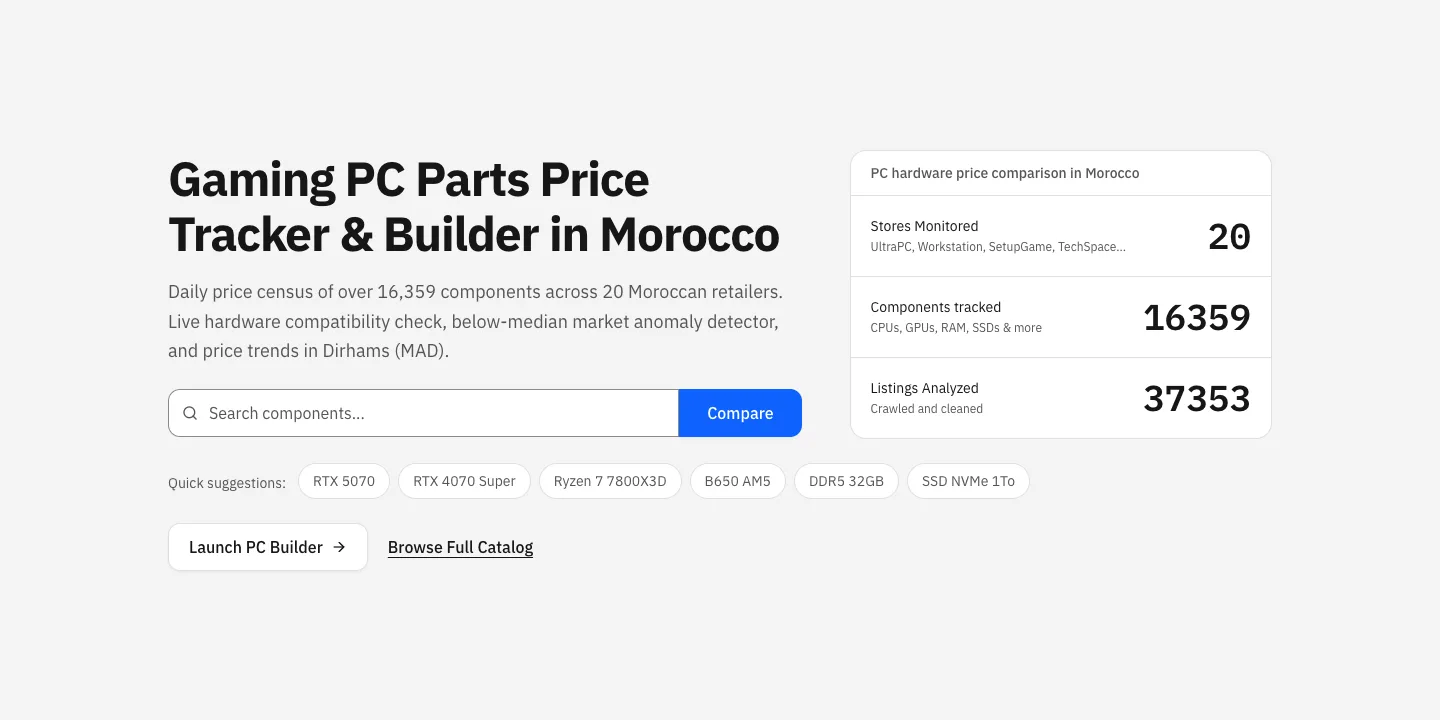
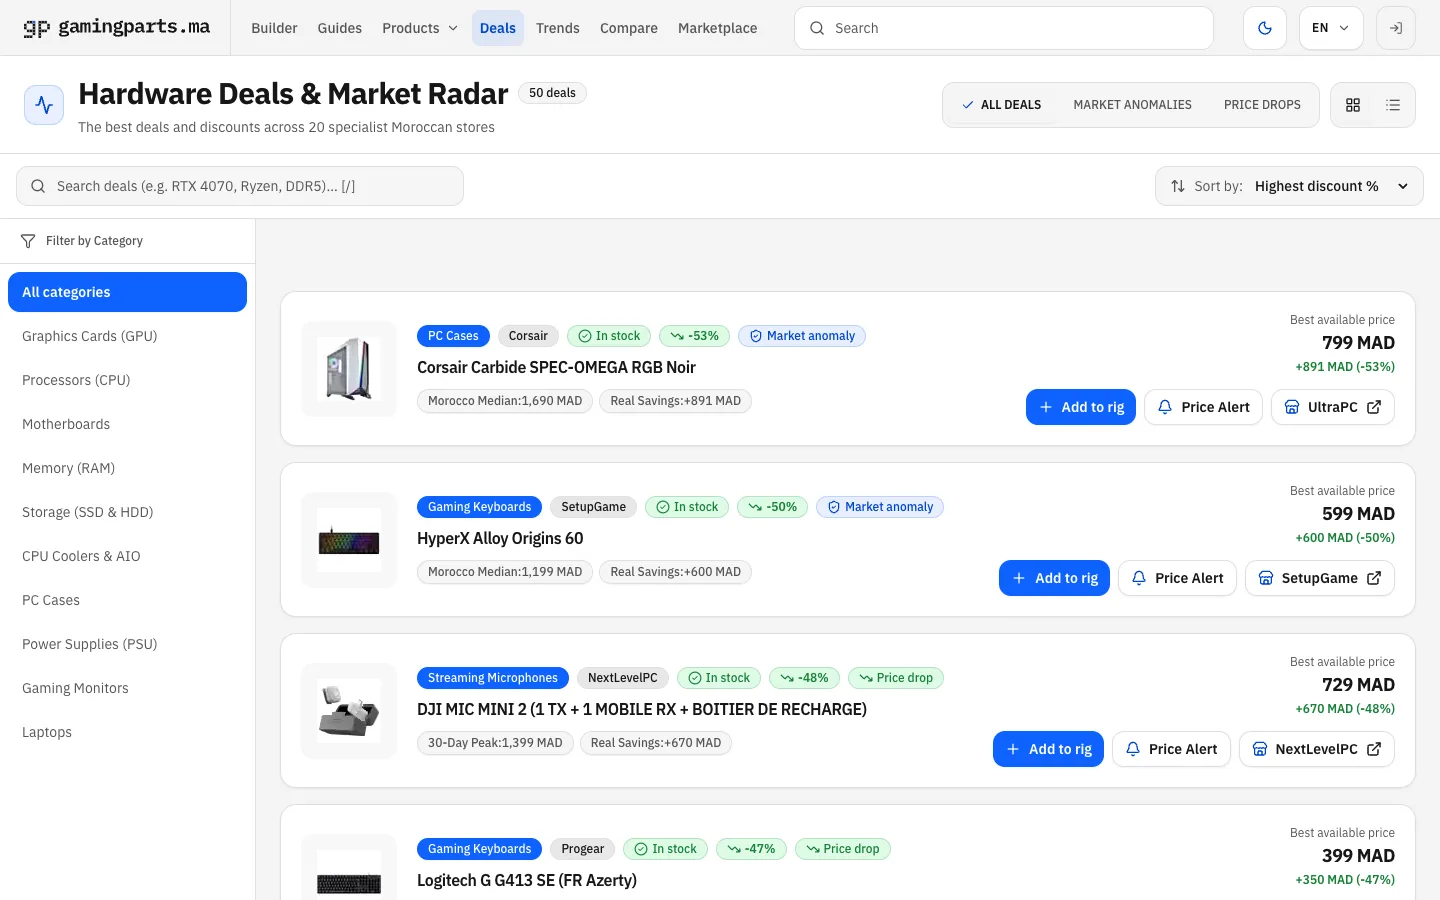
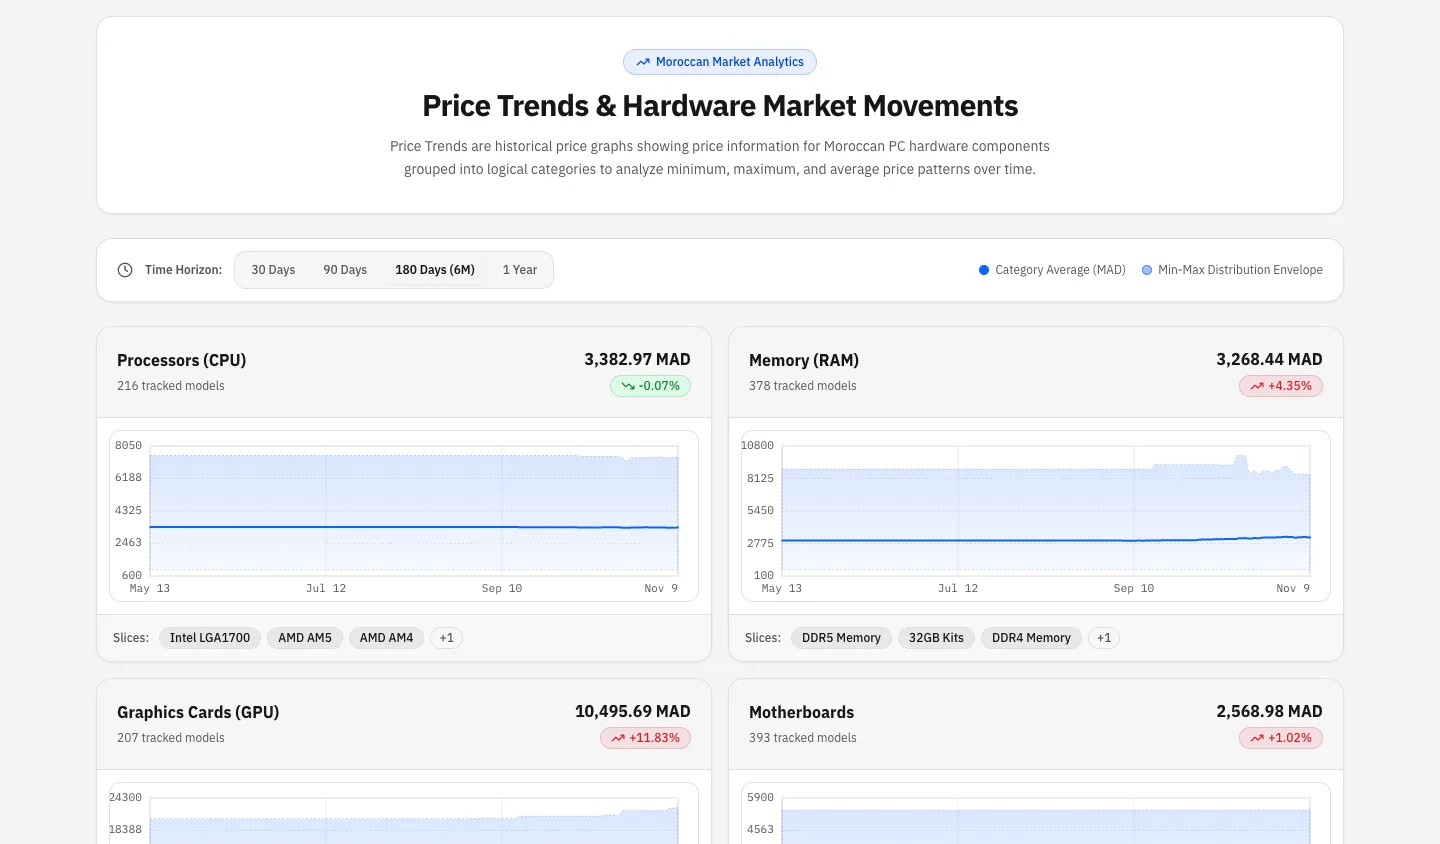
Les deux mécanismes qui font fonctionner l’ensemble
La plupart des comparateurs répondent à « est-ce un bon prix ? » par rapport au prix catalogue ou à un seul grand revendeur mondial. Ni l’un ni l’autre n’aide un acheteur à Casablanca. Le seul chiffre exploitable, c’est ce que les autres boutiques marocaines pratiquent aujourd’hui pour le produit strictement identique.
La plateforme repose donc sur deux mécanismes qu’un comparateur générique ne pourrait pas revendiquer honnêtement :
- Un recensement quotidien des prix. Chaque annonce est photographiée une fois par jour, ce qui produit une série de prix par boutique et par jour. Cet historique permet de répondre à « est-ce le bon moment pour acheter ? » au lieu de deviner.
- Des bonnes affaires mesurées par rapport à la médiane inter-boutiques. Une bonne affaire est une annonce nettement en dessous de ce que les autres boutiques demandent pour le même produit.
Architecture

Le backend est en Python 3.11, FastAPI, SQLModel et Alembic sur PostgreSQL 16. Le frontend est en Next.js 15 (App Router), React 19 et Tailwind 4, avec Zustand et TanStack Query. Docker Compose fait tourner les services : l’API, un service de place de marché séparé, le frontend, une tâche de revalidation du cache après déploiement, Caddy pour le TLS et un Umami auto-hébergé pour les statistiques. Le code représente environ 40 000 lignes de Python et 47 000 lignes de TypeScript.
Un scraping anti-bot qui distingue limitation de débit et défi
C’était le vrai défi d’ingénierie. Les scrapers des boutiques reposent sur
Scrapling, et la classe de base Scraper gère tout
le transport derrière une échelle d’escalade au coût croissant : une requête ne devient plus
coûteuse que si elle en a besoin.
- Une requête statique avec usurpation de l’empreinte TLS. Elle traite la majorité des cas.
- Une nouvelle tentative avec d’autres empreintes de navigateur.
- Un navigateur headless mutualisé qui résout Cloudflare Turnstile, borné à l’échelle du processus pour qu’un pool de workers ne lance pas des dizaines de navigateurs à la fois.
Le bug qui a façonné la conception
Quand une boutique vous bloque, le réflexe est d’escalader. C’est une erreur, et elle m’a coûté une réécriture. Un HTTP 429 n’est pas un défi. Le corps d’une réponse 429 n’est pas une page produit : l’analyser produit du bruit, et l’escalader vers un navigateur transforme une boutique limitée en milliers de lancements de navigateur. SetupGame limitait la plupart des requêtes, et le navigateur aggravait la situation.
Les deux cas suivent donc des chemins distincts. Un défi (403/503 ou page Turnstile)
monte l’échelle. Une limitation de débit est écartée et l’hôte est mis en attente par
HostThrottle : backoff exponentiel par hôte, respect de Retry-After, et plafond de
requêtes simultanées par hôte. Un hôte limité doit être ralenti, pas abandonné.
Depuis, le même principe a supprimé du travail. Quand une boutique expose une API produits publique (Osaka Gaming et SetupGame), le scraper lit les produits via l’API au lieu d’analyser du HTML. Les boutiques que Cloudflare bloque depuis le serveur sont rafraîchies depuis une machine locale et écrites dans la base de production par un tunnel SSH.
Protéger les données contre un mauvais crawl
Un scraper qui renvoie silencieusement zéro produit est pire qu’un scraper qui échoue bruyamment. Deux garde-fous entourent chaque exécution :
- Sélecteurs auto-réparateurs. Un mode optionnel mémorise l’empreinte de la grille catalogue de chaque boutique et la retrouve après une refonte, de sorte qu’une classe CSS renommée ne vide pas une boutique.
- Un garde-fou de nettoyage. Les annonces qui disparaissent d’une boutique sont retirées, mais si une exécution perd plus de 15 % des annonces d’une boutique, le nettoyage est ignoré et un avertissement est émis. Une boutique qui répond 404 sur la plupart de ses pages n’est pas retirée non plus.
Chaque exécution enregistre aussi les durées, les requêtes et les 429 par boutique : un revendeur lent ou limité est visible au lieu d’être supposé.
La fusion des catalogues, qui est le vrai produit
Vingt revendeurs, aucun modèle de données commun. La même carte graphique apparaît sous trois noms différents dans trois boutiques, et sans fusion, la comparaison est impossible : on ne peut pas calculer une médiane sur des lignes qui ne sont pas le même produit.
- Des normaliseurs de titres et de spécifications analysent chaque catégorie (CPU, GPU, carte mère, RAM, stockage, alimentation, boîtier, refroidisseur), extraient la couleur et la variante, normalisent sockets, générations DDR et formats, et refusent de classer les PC préassemblés et les portables comme des composants.
- Des catalogues de référence pour les CPU, GPU et cartes mères fournissent des spécifications que les revendeurs ne publient pas, ce qui permet d’afficher une fiche technique complète.
- Les variantes sont regroupées. Les conditionnements boîte, tray et bulk d’un même
modèle partagent une seule page produit, et une règle unique (
offer_policy) décide ce qui constitue une offre achetable.
La détection de bonnes affaires avec une médiane, pas une moyenne
La première version de la page des bonnes affaires était fausse, et le bug a été instructif. L’implémentation naïve comparait le prix de chaque boutique à la moyenne de ses pairs. Elle produisait n’importe quoi, à cause d’un défaut dans les données : les PC de bureau préassemblés sont classés sous le CPU cité dans leur titre. Un PC « Ryzen 5 5600 + RTX 5060 » à 8 999 MAD se retrouvait dans un groupe d’environ 1 349 MAD de processeurs seuls, tirait la moyenne vers le haut et faisait passer des CPU au juste prix pour des remises de 40 %. Triés par remise, les produits corrompus arrivaient en tête.
Le correctif a trois volets :
- La référence est la médiane, qu’une seule valeur aberrante ne peut pas déplacer.
- Un filtre de plausibilité (
MARKET_PLAUSIBILITY_FACTOR = 2.5) écarte les annonces très au-dessus de la médiane de leurs pairs avant de calculer la référence. Une annonce à 3× ses pairs est un autre produit classé sous le mauvais nom, pas une bonne affaire. - Une comparaison inter-boutiques exige au moins trois boutiques distinctes
(
MARKET_MIN_STORES = 3), et une boutique qui liste le même produit sous quatre URL ne compte qu’une fois.
Un second détecteur traite les baisses historiques avec la même prudence : fenêtre de 90 jours, rejet des échantillons supérieurs à 2× le prix actuel, et un nombre minimal d’observations avant de croire à une « baisse ». Une seule observation erronée ne doit jamais pouvoir fabriquer une remise.
Un moteur de compatibilité matérielle
Le configurateur n’est pas une simple liste de souhaits. evaluateSystemCompatibility()
applique neuf règles à la sélection courante et renvoie des problèmes typés, avec une
gravité qui se traduit dans l’interface :
| # | Règle | Gravité |
|---|---|---|
| 1 | Socket du CPU vs socket de la carte mère (LGA1700 / AM5 / …) | erreur |
| 2 | Génération DDR vs norme mémoire de la carte mère | erreur |
| 3 | RAM SO-DIMM de portable dans une configuration de bureau | erreur |
| 4 | Format de la carte mère vs formats pris en charge par le boîtier | erreur |
| 5 | Support du socket par le kit de fixation du ventirad | erreur |
| 6 | Longueur du GPU vs longueur maximale acceptée par le boîtier | erreur |
| 7 | Hauteur du ventirad vs dégagement du panneau latéral | erreur |
| 8 | Taille du radiateur AIO vs points de fixation du boîtier | avertissement |
| 9 | Ni iGPU ni GPU dédié, donc aucune sortie vidéo | avertissement |
Par-dessus ces règles statiques, un modèle de consommation additionne la puissance des composants, ajoute une marge et recommande une alimentation avec réserve, arrondie au-dessus. Il distingue un déficit critique (capacité nominale inférieure à la consommation réelle, une erreur) d’une réserve faible (un avertissement, car les pics de GPU ont besoin de marge). Une pièce candidate peut être simulée dans la configuration courante : le sélecteur marque un composant avant l’ajout, au lieu d’annoncer ensuite que la configuration est cassée.
Les configurations se partagent par un lien, sans serveur. La configuration est compressée
avec le CompressionStream natif du navigateur et placée dans le hash de l’URL, qui
n’atteint jamais le serveur : elle échappe donc aux limites de taille d’en-têtes. La
compression réduit la charge de 91 %, et le décodeur accepte quatre formats pour qu’un lien
partagé il y a des mois s’ouvre toujours.
Des alertes de prix sans doublon ni détournement
Les alertes sont optionnelles : un acheteur fixe un prix cible pour un produit et reçoit un email quand une boutique l’atteint. L’envoi des emails fonctionne en production via SMTP. Quelques décisions la rendent fiable :
- La propriété est confirmée. Un lien de confirmation est envoyé à l’adresse, et la gestion des alertes exige une adresse confirmée et un jeton signé par HMAC : personne ne peut lire ou supprimer les alertes d’autrui en devinant un identifiant. Le jeton de confirmation est tenu hors des index de recherche et des statistiques.
- Une alerte par acheteur et par produit. La création est un upsert sur un index unique partiel portant sur les lignes actives, pas une vérification lecture puis écriture. Deux requêtes simultanées, ce que produit un double clic, peuvent lire « aucune alerte active » avant que l’une écrive, et l’acheteur recevrait l’email deux fois.
- Seules les vraies offres déclenchent. Une alerte n’envoie jamais le prix d’une boutique inactive, et une forte baisse vue lors d’un seul crawl est retenue jusqu’à ce qu’un nouveau relevé la confirme, au lieu de réagir à une seule lecture étrange.
Une place de marché d’occasion
Un service séparé permet à des particuliers de vendre des pièces, des lots et des PC complets, chaque annonce étant comparée aux prix du neuf suivis le jour même. La connexion passe par Clerk, et les photos sont stockées sur Cloudflare R2.
Le stockage a son histoire. En octobre, le bucket de photos de production s’est vidé alors que la base les listait toujours comme prêtes. La cause probable était une seconde instance utilisant les mêmes identifiants et lançant son nettoyage nocturne. Je n’ai pas pu le prouver, alors j’ai rendu une récidive structurellement difficile :
- la production et le développement ne partagent jamais de bucket ni de jeton ;
- le nettoyage ne s’exécute que dans les environnements déployés ;
- un disjoncteur interrompt tout nettoyage qui supprimerait l’essentiel de ce qu’il a examiné, ou dont la base et le bucket n’ont aucune photo en commun ;
- un marqueur de propriétaire du bucket empêche un clone restauré de la base de nettoyer le mauvais bucket ;
- chaque suppression est un déplacement vers un préfixe
trash/verrouillé, pas un effacement.
Une base de code, un déploiement par pays
L’édition algérienne est un second projet Compose à côté du marocain, sur le même hôte. Elle a sa propre base Postgres, son backend et son frontend, et ne partage rien à l’exécution : un prix en dinars ne peut donc jamais atteindre le recensement marocain. Ce que les pays partagent, c’est le code : correspondance, normalisation et catalogues de référence. Les seuils de prix absolus sont écrits en MAD et convertis par marché, de sorte qu’une même protection garde le même sens en dinars.
Visibilité dans les moteurs de recherche et performances
- Pages rendues côté serveur pour les moteurs de recherche. Chacune des 20 boutiques a
sa page, avec des pages par ville, des pages modèle comme « Prix RTX 5070 au Maroc » et une
fiche technique rendue côté serveur pour chaque produit. Les produits supprimés répondent
410et les produits fusionnés redirigent par un301. - Pages de catalogue rapides. Un endpoint de catalogue à facettes côté serveur renvoie une page par vue, les images passent par l’optimiseur de Next.js, et les pages sont mises en cache puis revalidées après chaque déploiement.
- Statistiques respectueuses de la vie privée. Umami auto-hébergé, sans cookies, a remplacé Google Analytics et collecte aussi les Core Web Vitals.
Design
L’interface suit un système clair piloté par des jetons : un thème Pure White par défaut et une alternative Carbon Dark, IBM Plex Sans pour l’interface et IBM Plex Mono à chiffres tabulaires pour tous les nombres, afin que les colonnes de prix s’alignent. Deux conventions séparent la mesure du marketing. Les offres en rupture de stock sont dans leur propre groupe, pour qu’un prix inachetable ne puisse jamais gagner un « moins cher aujourd’hui », et chaque écart est exprimé par rapport à sa base (« 1 109 MAD sous la médiane du marché marocain »). J’ai aussi dessiné l’identité : un pictogramme « gp » en pixels avec un logotype monospace, construit autour de l’idée que la médiane est une règle que seule la boutique la moins chère vient briser.
Sécurité, déploiement et qualité
- Sécurité. Une protection SSRF sur chaque requête sortante, une authentification d’administration qui refuse par défaut, des routes d’exploitation derrière une authentification basique, et des validateurs de configuration qui refusent de démarrer en production avec un réglage dangereux. L’API publique refuse aussi les clients de collecte automatisée.
- Déploiement. La production tourne sur un VPS Oracle Cloud avec Docker Compose derrière
Caddy. Un seul script mène à la production : il déploie
origin/main, prend un verrou sur l’hôte, détecte les écarts entre le serveur et le dépôt, ne reconstruit que les services dont les entrées ont changé, vérifie la santé et sauvegarde ce qu’il remplace, de sorte qu’un retour arrière est une commande et non une reconstruction. - Tests. Plus de 2 000 tests backend et environ 850 tests frontend, exécutés par GitHub Actions à chaque pull request, avec un workflow de surveillance de disponibilité du site en production. Les tests backend sont adverses plutôt que guidés par la couverture : relocalisation des sélecteurs, distinction limitation de débit / défi, doublons de relevés de prix, propriété des jetons d’alerte et vérification de bout en bout de la complétude des champs sur un vrai scrape.
Ce que je ferais ensuite
- Ajouter une passe de régression visuelle qui rend chaque page dans les deux thèmes.
- Construire les fonctionnalités de marché local encore à la feuille de route : un panier à une ou deux boutiques au prix le plus bas, qui tient compte de la livraison de chaque revendeur, et un calculateur de surcoût « préassemblé contre montage soi-même ».